
Der vorliegende Beitrag argumentiert pointiert: KI wird Business Intelligence nicht ersetzen, sondern auf ein neues Niveau heben – von der reinen Berichterstattung hin zur systematischen Entscheidungsoptimierung. Voraussetzung ist jedoch eine saubere Datenbasis, klar definierte Datenprodukte und eine Plattformarchitektur, die Large Language Models strukturierten Zugriff auf kuratierte Informationen ermöglicht. LLMs sind keine Kristallkugeln. Sie entfalten ihren Mehrwert erst dann, wenn sie über Kataloge, Semantik und Metadaten gezielt auf hochwertige Daten zugreifen können.
Anhand eines realisierten Proof of Concept wird gezeigt, wie ein natürlichsprachliches Q&A-Interface auf einer Datenplattform SQL generiert, Kontextquellen einbindet und Ursache-Wirkungs-Zusammenhänge erklärt. Entscheidend ist dabei nicht die Automatisierung von Antworten, sondern die Optimierung von Entscheidungen – im Zusammenspiel von Menschen und KI.
Die Zukunft der BI liegt nicht im Chatbot, sondern in einer strategischen Daten- und KI-Plattform, die aus Daten belastbare Handlungsoptionen ableitet. Der Mensch bleibt dabei die letzte Instanz – nicht als Bremse, sondern als verantwortlicher Entscheider im Loop.
Ist KI der Tod der BI? Nein. Aber sie beendet ihre Komfortzone.
„Warum waren die Absätze am 28.11. so hoch und am 20.4. so niedrig?“
Noch vor wenigen Jahren hätte diese Frage eine Kette von Arbeitsschritten ausgelöst: Report öffnen, Filter setzen, Daten exportieren, SQL anpassen, Kontext recherchieren, Kampagnenkalender prüfen, Wetterdaten vergleichen. Heute reicht ein Satz in natürlicher Sprache – und ein Large Language Model generiert die Abfrage, identifiziert Black Friday und Ostermontag, verknüpft Kampagneninformationen und liefert eine Erklärung [1].
Ist das das Ende der Business Intelligence? Wer diese Frage stellt, denkt zu klein. KI ist nicht der Totengräber der BI. Sie ist ihr Evolutionsbeschleuniger. Sie beendet nicht die Disziplin – sie beendet ihren Stillstand.
Was gerade entsteht, ist keine neue Oberfläche. Es ist ein neues Paradigma. Business Intelligence entwickelt sich von der Berichterstattung zur systematischen Entscheidungsoptimierung. Und genau darin liegt ihre Zukunft.
LLMs sind keine Kristallkugeln – sie sind Verstärker
Die aktuelle Euphorie um „Chat with your data“ suggeriert ein einfaches Vorgehen: Man verbindet ein Sprachmodell mit einer Datenbank – und plötzlich wird jede Frage beantwortet. Doch diese Vorstellung ist gefährlich verkürzt.
Ein Large Language Model weiß nichts über Ihr Unternehmen. Es kennt keine Definition Ihrer Kennzahlen, keine impliziten Geschäftslogiken, keine Besonderheiten Ihres Datenmodells. Ohne Kontext bleibt es ein eloquenter Wahrscheinlichkeitsrechner.
Die entscheidende Erkenntnis lautet deshalb: Ein LLM wird erst dann zum Entscheidungsmotor, wenn es strukturierten, semantisch sauberen Zugriff auf hochwertige Daten bekommt.
Das bedeutet: Das Modell muss verstehen, welche Tabellen existieren, wie sie strukturiert sind, welche Felder welche Bedeutung tragen und wie Kennzahlen fachlich definiert sind. Es muss unterscheiden können, ob „Absatz“ die verkaufte Menge, den fakturierten Umsatz oder die ausgelieferte Stückzahl meint. Es muss wissen, welche Daten qualitätsgesichert sind – und welche nicht.
Ohne Datenkatalog, ohne Business-Glossar, ohne klare Semantik bleibt jedes noch so leistungsfähige Modell ein Rater. Mit sauber kuratierten Daten wird es zu einem Analyseinstrument.
Damit verschiebt sich der Fokus radikal: Nicht das Modell ist der Engpass, die Datenreife ist es [2].
Der eigentliche Gamechanger ist die Plattform – nicht der Chat
Ein funktionierendes „Chat with your Data“-System ist mehr als ein LLM mit Datenbankanbindung. Es ist eine Architekturentscheidung – und diese Architektur entscheidet darüber, ob das System Vertrauen verdient oder lediglich beeindruckt.
Im Rahmen eines Proof of Concept (PoC) wurde eine solche Architektur realisiert und unter produktionsnahen Bedingungen erprobt. Technisch basiert der PoC auf der SAP BTP, SAP HANA und Databricks als zentraler Plattform. Das Backend ist als FastAPI-Dienst in Python implementiert und kommuniziert über den Databricks AI Gateway mit Claude Sonnet als Large Language Model. Die Datenhaltung erfolgt in SAP Datasphere auf Basis von SAP HANA Cloud; der Datenzugriff wird über die hdbcli-Bibliothek realisiert. Als Agent-Framework kommt LangChain zum Einsatz – konkret mit dem AGENTTYPE CHAT_CONVERSATIONAL_REACT_DE-SCRIPTION, der einen iterativen Reasoning-Prozess nach dem ReAct-Muster (Reason + Act) umsetzt (siehe Abbildung 1) [3; 4; 5; 6].
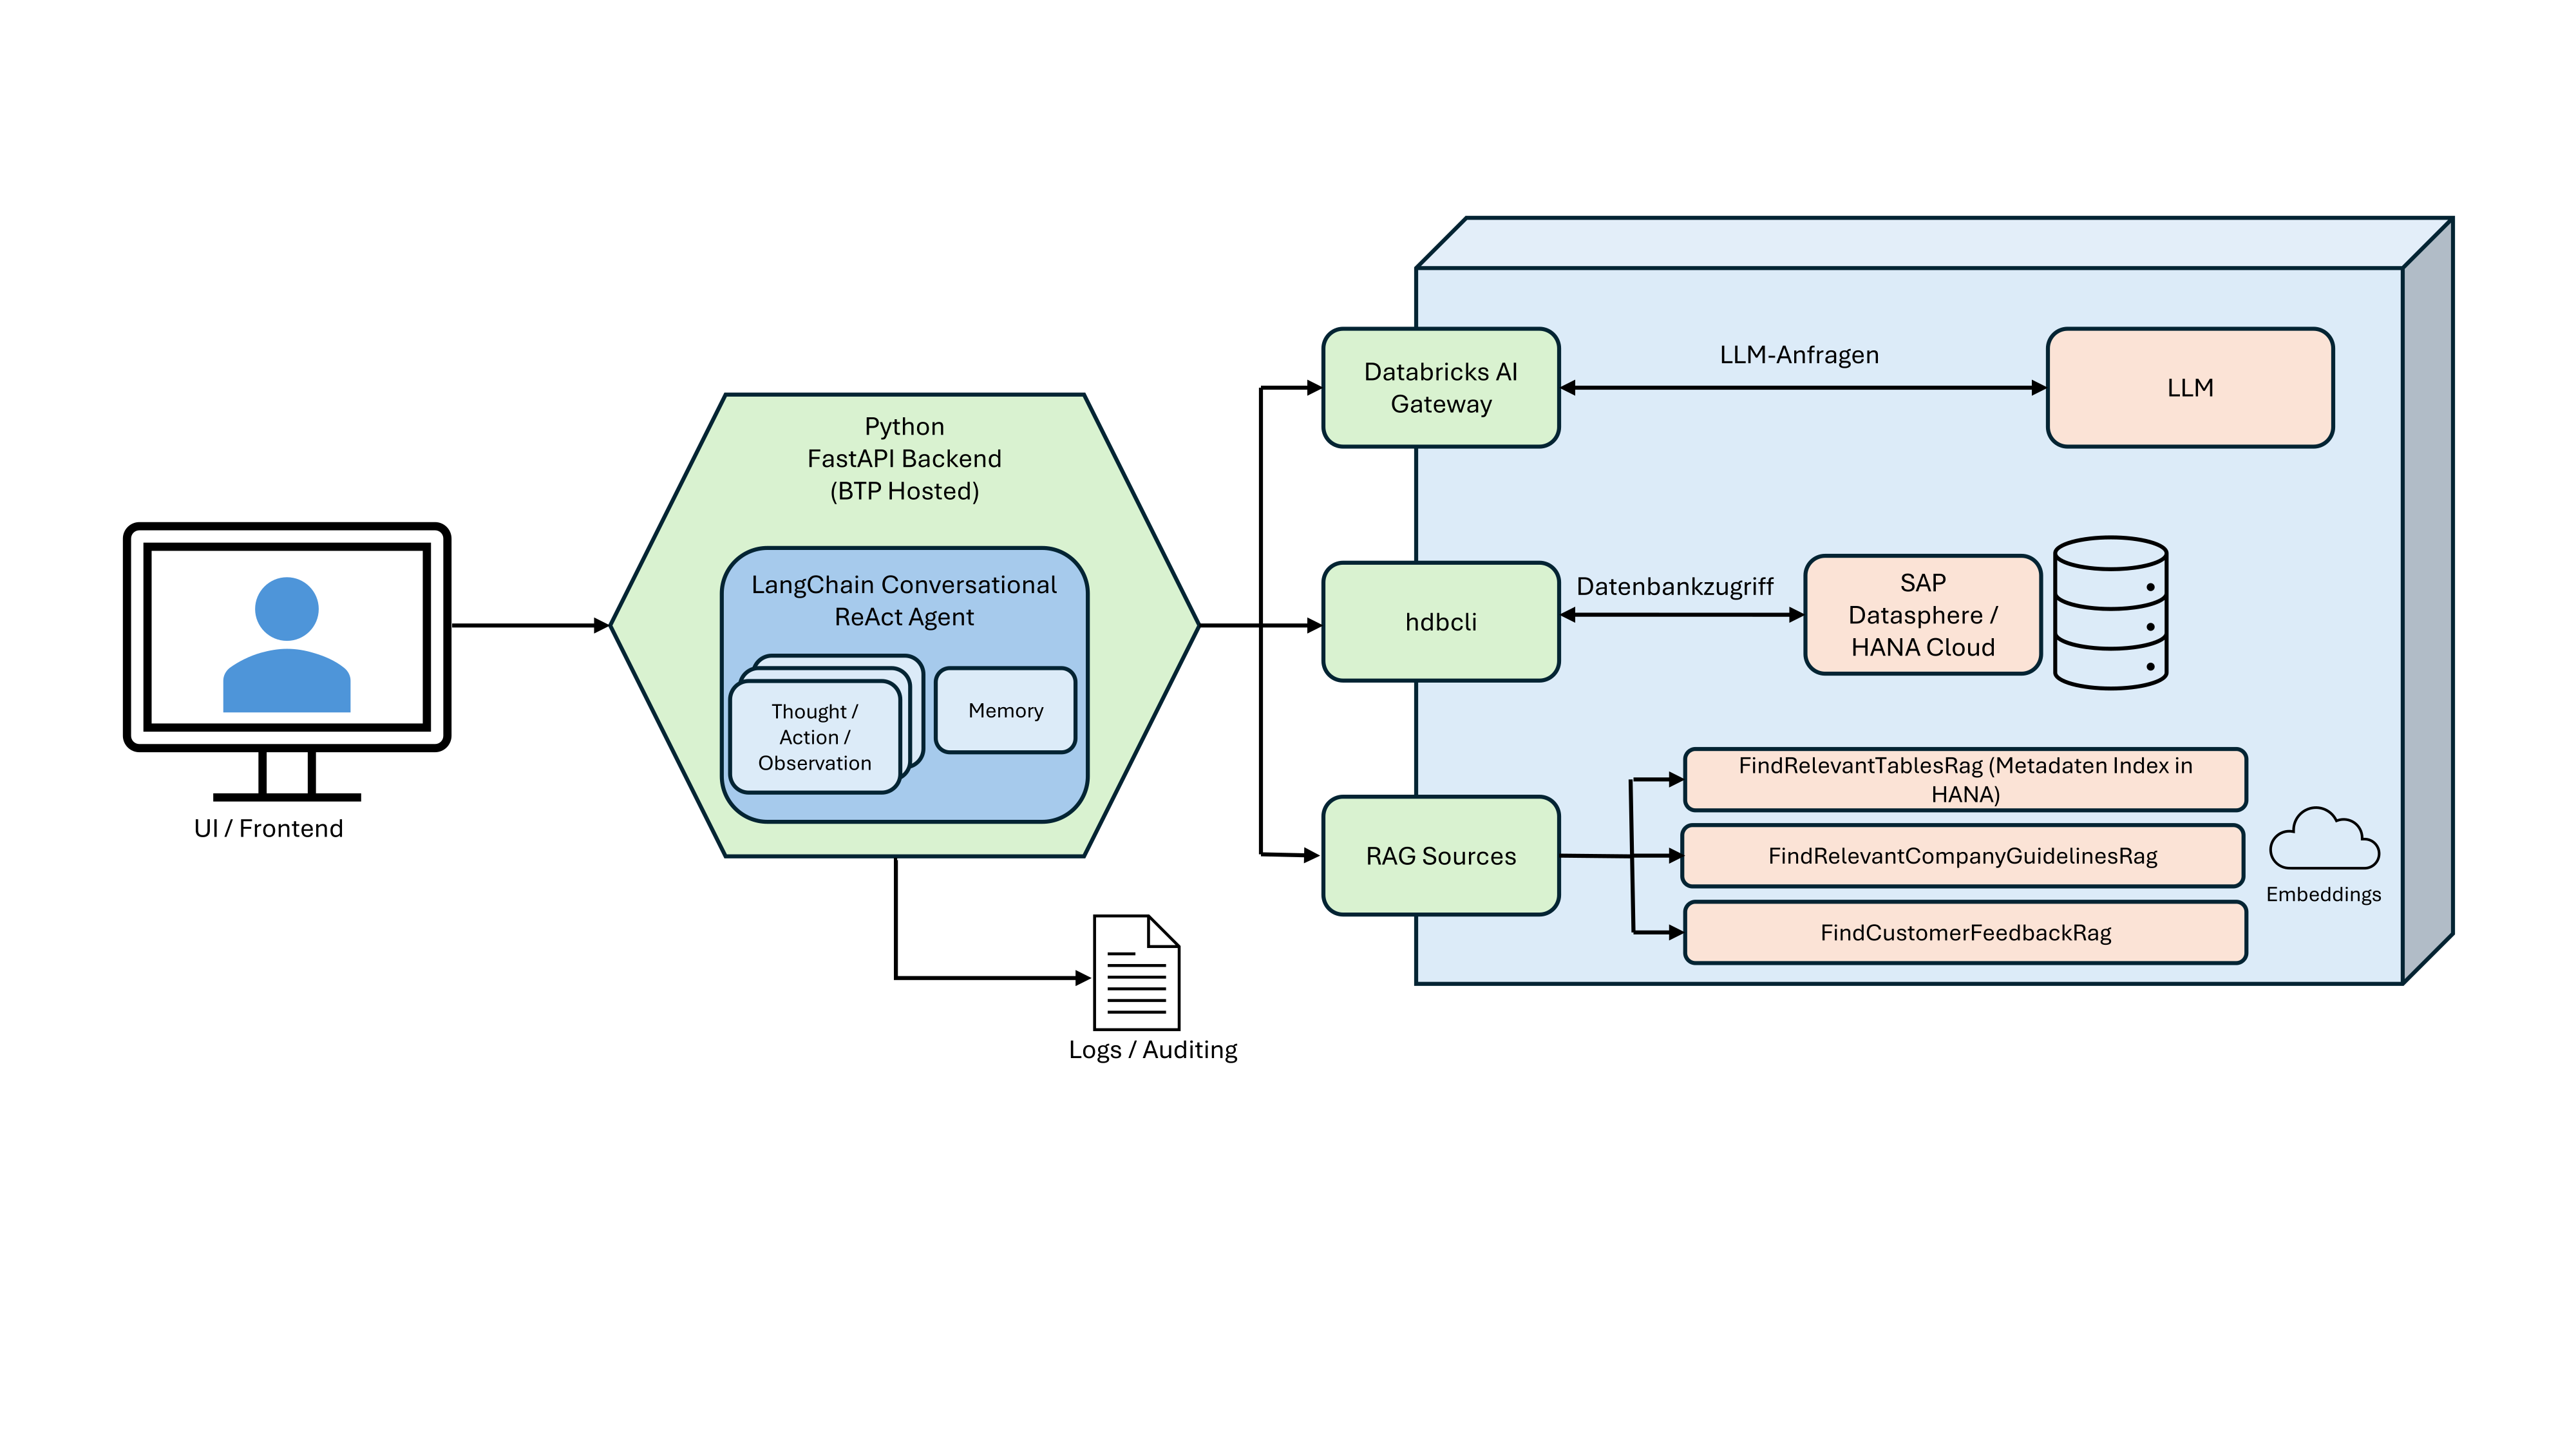
Abb. 1: Systemarchitektur des PoC
Das LLM erhält nicht die Rohdaten, sondern die Werkzeuge, um gezielt auf sie zuzugreifen. Diese Differenzierung ist entscheidend, denn sie trennt Spielerei von Professionalität.
Der Werkzeugkasten: Sieben spezialisierte Tools
Das zentrale Architekturprinzip: Das LLM erhält keinen direkten Datenbankzugriff. Stattdessen orchestriert es einen kontrollierten Werkzeugkasten aus sieben spezialisierten Tools, die jeweils eine klar definierte Funktion übernehmen (siehe Tabelle 1).
| Tool | Funktion |
|---|---|
| FindRelevantTablesRAG | Semantische Vektorsuche über Tabellenbeschreibungen via Cosine Similarity in HANA |
| FindRelevantCompanyGuidelinesRag | RAG über interne Firmenrichtlinien-Embeddings |
| FindCustomerFeedbackRag | RAG über Kundenfeedback-Embeddings |
| ListViews / DescribeView | Metadaten-Lookup für Schema und Spaltenstruktur |
| RunSQL | Kontrollierte SQL-Ausführung mit User-Context-Propagation |
| GenerateChart | Diagramm-Konfigurationsgenerator für das Frontend |
| DuckDuckGo Search | Allgemeine Wissensfragen außerhalb der Datenbank |
Embeddings werden mit dem Modell databricks-gte-large-en erzeugt und in dedizierten HANA-Vektortabellen gespeichert. Dieses Design hat eine wichtige Konsequenz: Das LLM agiert als Orchestrator, nicht als Datenquelle. Es entscheidet, welches Werkzeug wann eingesetzt wird – die eigentliche Datenverarbeitung bleibt in kontrollierten, auditierbaren Systemkomponenten.Genau diese Trennung ist der Gamechanger – nicht der Chat-Kanal als Oberfläche, sondern die Plattformlogik darunter: semantisch angereicherte Datenprodukte, vektorsuchfähige Beschreibungsschichten, klar definierte Tool-Interfaces und eine Sicherheitsarchitektur, die Datenzugriff auch im KI-Kontext kontrollierbar hält.Das Modell greift auf Kataloginformationen zu, liest Schema-Metadaten aus, nutzt definierte Glossarbegriffe und orchestriert Abfragen gegen verschiedene Quellen. Es generiert SQL, führt Joins aus, erweitert den Kontext und validiert Zwischenergebnisse – Schritt für Schritt, wie im nachfolgend dargestellten Reasoning-Prozess beschrieben.Die Antwort entsteht nicht aus „Magie“, sondern aus strukturiertem Zugriff, kontrolliertem Querying und iterativem Reasoning.Damit wird klar: Wer nur einen Chatbot implementiert, betreibt Kosmetik. Wer eine Datenplattform baut, betreibt Strategie. Damit wird der Chatbot zum AI-Analytics Agent.
Der Reasoning-Prozess – Schritt für Schritt
Was passiert zwischen der Frage „Warum waren die Absätze am 28.11. so hoch?“ und einer belastbaren Antwort? Im PoC ist dieser Prozess nicht als Black Box realisiert, sondern als auditierbare Abfolge von acht definierten Schritten – vollständig protokolliert im Backend als Thought/Action/Observation-Sequenz (siehe Abbildung 2).
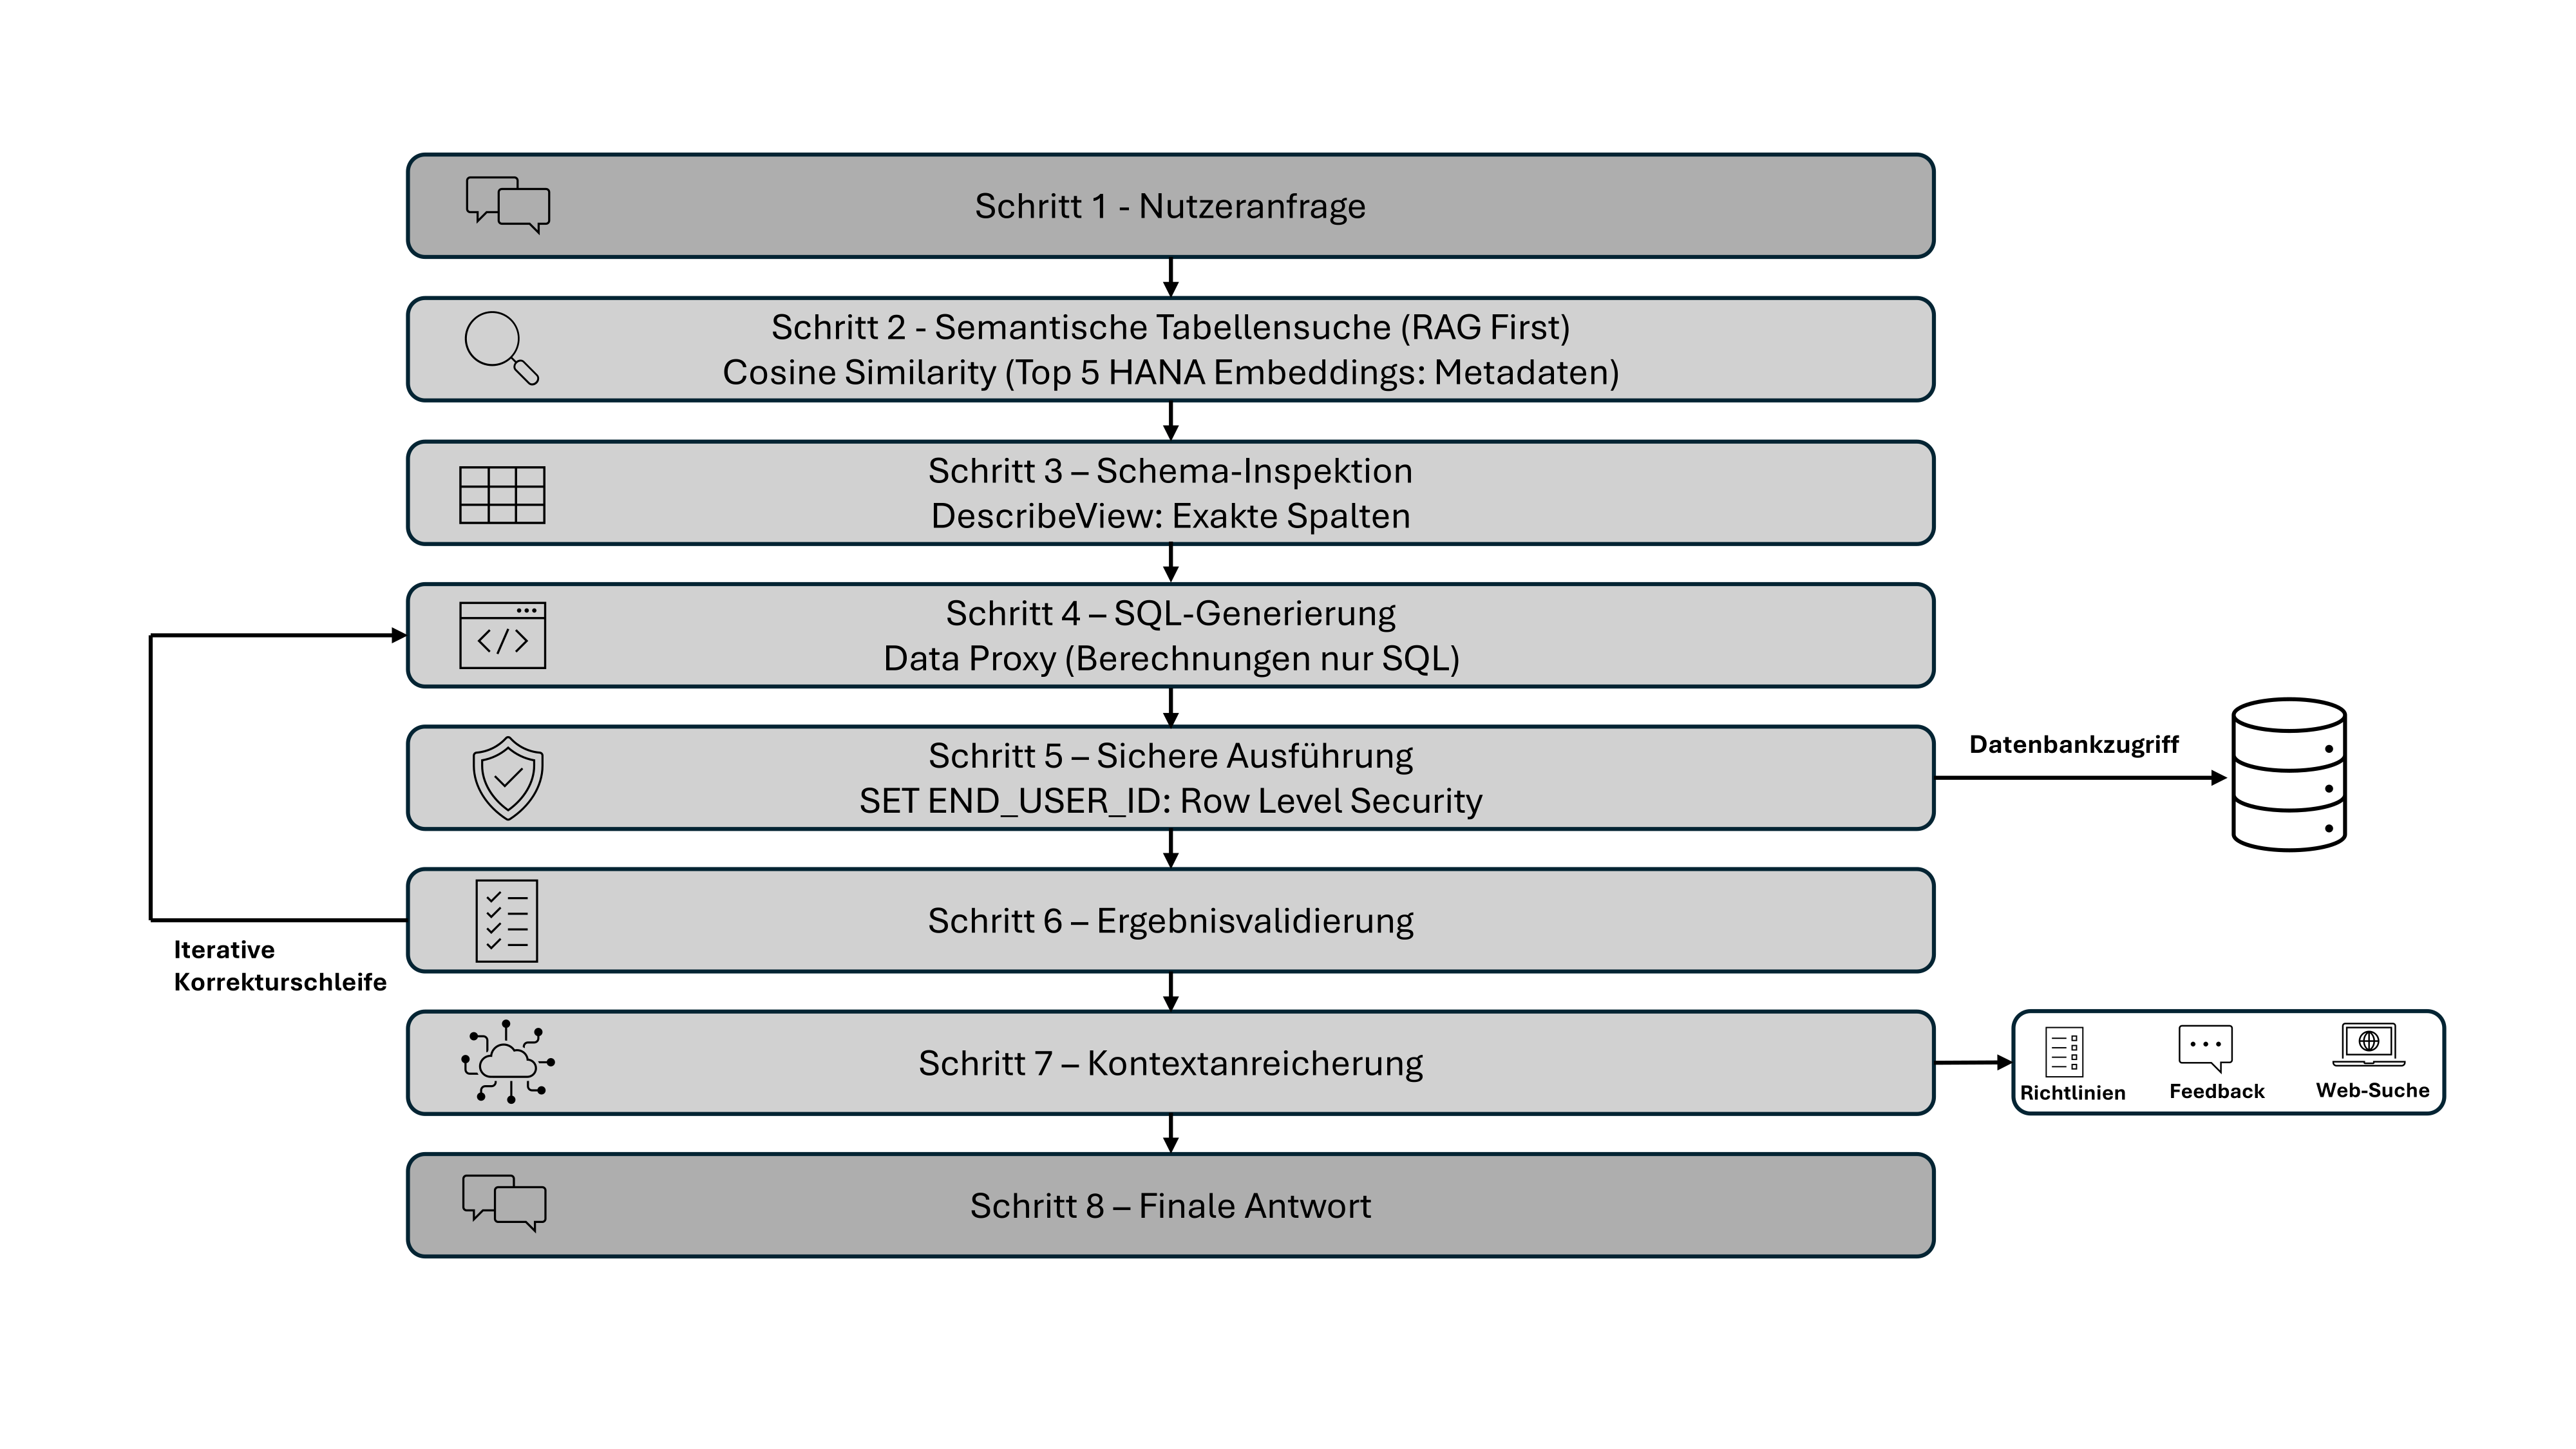
Abb. 2: Der 8-stufige Reasoning-Prozess
Schritt 1: Nutzeranfrage Der Nutzer stellt eine Frage in natürlicher Sprache. Das System empfängt sie über das FastAPI-Backend und übergibt sie an den LangChain-Agenten. Die Konversationshistorie wird als Memory mitgegeben, sodass Folgefragen im Kontext beantwortet werden können.
Schritt 2: Semantische Tabellensuche (RAG-First) Das LLM ruft FindRelevantTablesRAG auf. Die Nutzeranfrage wird in einen Embedding-Vektor umgewandelt; per Cosine Similarity werden die fünf semantisch ähnlichsten Tabellenbeschreibungen aus den vorbereiteten Embeddings in HANA identifiziert. Das LLM sieht in dieser Phase ausschließlich Metadaten – keine Rohdaten. Risiken wie mögliche Halluzinationen bei der Text-to-SQL-Generierung werden durch diesen Ansatz gezielt mitigiert [7].
Schritt 3: Schema-Inspektion Das LLM ruft DescribeView auf der relevantesten Tabelle auf und erhält die exakten Spaltennamen, Datentypen und Beschreibungen. Erst nach diesem Schritt kennt das Modell die tatsächliche Struktur der Daten – ein bewusstes Design, das verhindert, dass das LLM aufgrund von Annahmen SQL generiert.
Schritt 4: SQL-Generierung Auf Basis der validierten Spalteninformationen formuliert das LLM eine präzise SQL-Abfrage. Ein zentrales Konfigurationsprinzip: Berechnungen – Raten, Prozentwerte, Aggregationen – müssen zwingend in SQL erfolgen. Das LLM ist im System Prompt explizit als „Data Proxy“ konfiguriert und ist angewiesen, keine mentalen Berechnungen durchzuführen. Dieser Grundsatz ist entscheidend für die Verlässlichkeit numerischer Ergebnisse.
Schritt 5: Sichere Ausführung RunSQL führt die Abfrage aus. Für jede Session wird die authentifizierte User-ID über SET ‚END_USER_ID‘ an HANA übergeben. Damit greift die in SAP Datasphere konfigurierte Row-Level-Security vollständig – ohne Umgehungsmöglichkeit durch das LLM. Jeder Nutzer sieht exakt die Daten, für die er autorisiert ist [8].
Schritt 6: Ergebnisvalidierung Das LLM evaluiert, ob das zurückgegebene Ergebnis die ursprüngliche Frage tatsächlich beantwortet. Ist das Ergebnis unvollständig oder inkonsistent, initiiert der Agent eine iterative Korrekturschleife: neue SQL-Formulierung, erneute Ausführung, erneute Prüfung. Dieses Muster entspricht dem ReAct-Ansatz und macht das System robust gegenüber Fehlformulierungen im ersten Durchgang [5; 9].
Schritt 7: Kontextanreicherung Sofern die Fragestellung es erfordert, werden parallel RAG-Tools aufgerufen: FindRelevantCompanyGuidelinesRag liefert relevante interne Richtlinien, FindCustomerFeedbackRag ergänzt mit Kundenstimmen. Das Ergebnis ist eine Antwort, die nicht nur auf Datenbankwerten basiert, sondern auf einem mehrdimensionalen Informationsraum.
Schritt 8: Finale Antwort Das LLM formuliert eine natürlichsprachliche Antwort – präzise, kontextualisiert und nachvollziehbar. Bei quantitativen Ergebnissen wird optional eine Chart-Konfiguration für das Frontend generiert, sodass die Visualisierung direkt aus dem Reasoning-Prozess entsteht.Dieser achtstufige Prozess ist vollständig auditierbar. Jeder Zwischenschritt – jeder Thought, jede Action, jede Observation – wird im Backend protokolliert. Das ist kein Zugeständnis an Compliance-Anforderungen, sondern eine epistemische Notwendigkeit: Ein System, das Entscheidungen optimiert, muss selbst erklärbar sein.
Kontext ist kein Nice-to-have – er ist der Unterschied zwischen Erklärung und Entscheidung
Absatzdaten sagen, was passiert ist. Sie liefern Zahlen, Peaks, Dellen. Doch Zahlen ohne Kontext sind bedeutungslos. Erst durch die Verknüpfung mit Kalenderinformationen, Kampagnenlogiken, Promotionen oder externen Einflussfaktoren wie Wetter oder Logistik entsteht Erklärungskraft. Und erst Erklärungskraft ermöglicht bessere Planung.Der PoC adressiert das Problem fehlenden Kontexts durch mehrere Schichten: Tabellenbeschreibungen als semantische Metadaten, Firmenrichtlinien als vektorsuchfähige Wissensbasis und Kundenfeedback als qualitative Ergänzung zu quantitativen Datenbankwerten. Das LLM erhält damit nicht nur Zahlen – es erhält Bedeutung.Hier zeigt sich eine der größten strategischen Implikationen: Die Anzahl und Qualität angebundener Datenquellen wird zum Wettbewerbsfaktor. Unternehmen, die ihre Datenquellen isoliert betrachten, betreiben Rückspiegelanalyse. Unternehmen, die Kontext systematisch integrieren, schaffen Entscheidungsfähigkeit.Die Diskussion verschiebt sich damit von „Welches Modell nutzen wir?“ hin zu „Welche Datenprodukte benötigen wir, um bessere Entscheidungen zu treffen?“.Der Unterschied zwischen Erklärung und Entscheidung liegt im Kontext. Und Kontext ist keine natürliche Eigenschaft von Daten – er muss systematisch aufgebaut, gepflegt und zugänglich gemacht werden. Das ist Plattformarbeit, nicht KI-Magie.Der finale Erfolg des PoC misst sich an klar definierten quantitativen Kriterien, insbesondere der Trefferquote des RAG-Systems bei der Tabellenidentifikation sowie dem Prozentsatz der syntaktisch fehlerfrei generierten SQL-Abfragen.Die Belastbarkeit der Ergebnisse wurde durch eine systematische, vergleichende Analyse sichergestellt, bei der die Auswirkungen spezifischer Einflussfaktoren auf die Qualität der Agenten-Antwort isoliert und gemessen wurden. Das durchgängige Logging aller Agentenaktionen ermöglichte zudem eine vollständige Nachvollziehbarkeit des Entscheidungs- und Abfrageprozesses und bildete die Grundlage für eine systematische Qualitätssicherung.
Nachweis der Hebelwirkung von Metadaten
Zur Bewertung wurde eine mehrstufige Klassifikation in 5 Stufen für die Qualität der Agenten-Antworten eingeführt, die von „unvollständig/irreführend“ bis zu „vollständig, präzise und proaktiv aufbereitet“ reichte. Anschließend wurde die Verteilung der Antworten auf diese Qualitätsklassen in zwei Szenarien verglichen: einem mit minimalen, rein schematischen Metadaten und einem mit fachlich angereicherten Metadaten.Das Ergebnis war eindeutig und quantifizierbar: Die Anreicherung der Metadaten führte zu einer überproportionalen Steigerung der Antworten in den höchsten Qualitätsklassen. Der Anteil der als „unvollständig“ klassifizierten Antworten konnte signifikant reduziert werden, während sich die Anzahl der „präzisen und proaktiv aufbereiteten“ Antworten mehr als verdoppelte. Letztendlich konnte in dem PoC eine Trefferquote von über 90 Prozent erzielt werden. Durch weitere Anreicherung der Metadaten im produktiven Einsatz kann diese Quote gesteigert werden.
Nachweis der Effizienz der Nutzerinteraktion
Analog wurde die Robustheit gegenüber der Nutzerinteraktion untersucht, indem die durchschnittliche Antwortqualität für kurze, intuitive Anfragen (unter 15 Tokens) mit der für lange, detaillierte Anweisungen (über 60 Tokens) verglichen wurde. Hierfür wurden 15 Kolleginnen und Kollegen mit unterschiedlichem Erfahrungsschatz im Bereich der KI für ausführliche Tests herangezogen.Die Analyse zeigte, dass die durchschnittliche Antwortqualität deutlich abfiel und Halluzinationen vermehrt auftraten, wenn Nutzer kurze statt langer, detaillierter Prompts verwendeten. Das System erreichte durch präzise Eingaben und Aufforderungen, die Vorgehensweise darzulegen, konsistent die höchsten Qualitätsklassen, was die Wichtigkeit präziser Fragestellungen/Prompts belegt.Zur weiteren Qualitätssicherung können zudem spezialisierte KI-Agenten als automatisierte Kontrollinstanz implementiert werden, um die generierten Ergebnisse inhaltlich zu validieren.
Von der Analyse zur Optimierung: Der eigentliche Paradigmenwechsel
Klassische BI war retrospektiv. Sie beantwortete die Frage, was passiert ist. Moderne, KI-gestützte BI erweitert diesen Horizont:
- Sie analysiert Ursachen.
- Sie simuliert Szenarien.
- Sie prognostiziert Entwicklungen.
- Und sie empfiehlt Handlungsoptionen. Der Schritt vom Insight zur Aktion ist kein technisches Upgrade – er ist ein strategischer Bruch.
Wenn ein System nicht nur erklärt, warum ein Verkaufstag erfolgreich war, sondern vorschlägt, wie Budget, Personal und Lagerbestand im kommenden Jahr angepasst werden sollten, dann entsteht ein neues Entscheidungsniveau. Wenn Simulationen Zielkonflikte zwischen Marge und Kundenzufriedenheit sichtbar machen, wird BI zum Sparringspartner der Geschäftsführung.Hier liegt die eigentliche Revolution: KI verschiebt BI von der Beobachtung zur Optimierung.
Sicherheitsarchitektur und Datenzugriffskontrolle
Ein Chat-Interface, das auf Unternehmensdaten zugreift, ist ein Angriffsziel. Nicht theoretisch – praktisch. Ein produktionsfähiges System muss deshalb von Anfang an mit einer mehrschichtigen Sicherheitsarchitektur konzipiert werden. Der PoC adressiert dies durch vier ineinandergreifende Sicherheitsebenen.
Authentifizierung und Autorisierung
Der Zugriff auf das System wird über JWT-basierte Authentifizierung (OAuth2, HS256) gesichert. Passwörter werden mit bcrypt gehasht gespeichert. Jede API-Anfrage erfordert einen validen Token – ohne diesen ist kein Datenzugriff möglich. Enterprise-Ready wird die Umsetzung der Authentifizierung und Autorisierung durch die Nutzung eines IDP.User-Context-Propagation Das Herzstück der Datenzugriffskontrolle ist die Weitergabe der authentifizierten User-ID an jede HANA-Session. Über SET ‚END_USER_ID‘ vor jeder SQL-Ausführung greift die in SAP Datasphere konfigurierte Row-Level-Security automatisch und unumgehbar. Das bedeutet: Selbst wenn das LLM eine SQL-Abfrage formuliert, die theoretisch auf Daten außerhalb des Nutzerbereichs zugreift, filtert HANA diese auf Datenbankebene heraus. Das LLM kann diese Kontrolle weder umgehen noch erkennen [8].
Kontrollierter Datenzugriff
Das LLM sieht zu keinem Zeitpunkt Rohdaten direkt. Es erhält ausschließlich Tool-Outputs – strukturierte, bereits gefilterte Ergebnisse aus dem jeweiligen Werkzeug. Diese Indirektionsstufe ist eine bewusste Architekturentscheidung: Sie verhindert, dass das LLM als Datenaggregator missbraucht werden kann. Auch auf EU-Servern gehostete LLMs können in Betracht gezogen werden, insbesondere wenn durch die Verwendung eines Multi-Agent-Systems sowie vordefinierter Tools auf MCP-Servern komplexe Arbeitsabläufe flexibel auf verschiedene, spezialisierte Modelle verteilt werden.
Determinismusmaximierung
Das Modell ist mit einer Temperatur von 0,1 konfiguriert. Das minimiert die Varianz in den Ausgaben und erhöht die Reproduzierbarkeit – ein wichtiger Faktor für Systeme, die Entscheidungen optimieren. Vollständiger Determinismus ist bei LLMs nicht erreichbar, aber niedrige Temperatur reduziert nichtdeterministische Abweichungen erheblich. Die Temperatur eines LLMs kann daher als ein Maß für die Kreativität gelten [4].Sicherheit ist in diesem Kontext kein optionales Feature. Sie ist die Voraussetzung dafür, dass einem solchen System überhaupt Vertrauen entgegengebracht werden kann.
Was der PoC bewusst offenlässt
Ein Proof of Concept hat per Definition einen anderen Anspruch als ein produktionsreifes System. Der vorliegende Prototyp enthält bekannte Lücken – im Bereich Credentials-Management, Logging, Eingabevalidierung und Fehlerbehandlung –, die im aktuellen Kontext bewusst akzeptiert wurden, um den Fokus auf die konzeptionelle Machbarkeit zu legen. Sie sind keine übersehenen Defizite, sondern dokumentierte Schulden, die bei einer Überführung in den Produktivbetrieb systematisch adressiert werden müssen.Wer die Grenzen seines Systems kennt und benennt, zeigt, dass er sie verstanden hat.
Der Mensch bleibt im Loop – und genau das ist der Punkt
Je stärker Systeme Empfehlungen aussprechen, desto wichtiger wird menschliche Urteilskraft.Führungskräfte müssen Teams dazu befähigen, KI-Vorschläge kritisch zu reflektieren. Eine aktive Fehlerkultur ist notwendig, um Fehlinterpretationen nicht zu vertuschen, sondern daraus zu lernen. Bias – sowohl in Daten als auch in Modellen – muss systematisch identifiziert und adressiert werden.Der Mensch bleibt nicht im Loop, weil die Technologie unzureichend ist. Er bleibt im Loop, weil Verantwortung nicht delegierbar ist.KI kann Optionen bewerten. Sie kann Szenarien simulieren. Sie kann Wahrscheinlichkeiten berechnen. Aber sie trägt keine Haftung, keine strategische Gesamtverantwortung und keine ethische Verpflichtung.Die Zukunft gehört daher nicht autonomen Entscheidungssystemen, sondern kooperativen Entscheidungsarchitekturen.
Datenprodukte statt KI-Leuchttürme
Viele Organisationen starten mit isolierten KI-Projekten: ein Chatbot hier, ein Forecast dort. Das erzeugt Aufmerksamkeit – aber keine Systematik.Der nachhaltigere Ansatz ist die Entwicklung klar definierter Datenprodukte, die Tabellen, Semantik, Qualitätsregeln und Governance-Mechanismen bündeln. Ein Vertriebs-Insights-Datenprodukt beispielsweise schafft eine belastbare Grundlage, auf der unterschiedliche Anwendungsfälle aufsetzen können.Damit wird KI skalierbar. Nicht, weil das Modell größer wird, sondern weil die Datenbasis strukturierter wird [10].
Strategie statt Hype: Warum jetzt die Weichen gestellt werden müssen
„Chat with your data“ wird kommen. Nutzer werden erwarten, mit Daten in natürlicher Sprache zu interagieren. Doch die Frage ist nicht, ob Unternehmen ein solches Interface bereitstellen. Die Frage ist, ob sie die strategische Infrastruktur dahinter aufbauen.Die Vision ist nicht der eine intelligente Chatbot. Die Vision ist eine strategische Daten- und KI-Plattform, die natürlichsprachliche Fragen in belastbare Entscheidungen übersetzt.Das erfordert Klarheit darüber, welche Entscheidungsprozesse priorisiert werden sollen. Es erfordert Governance-Strukturen, Verantwortlichkeiten und Kompetenzaufbau. Vor allem aber erfordert es den Mut, BI nicht als Reporting-Funktion, sondern als strategischen Werttreiber zu positionieren.
Fazit: KI beendet nicht die BI – sie professionalisiert sie
Die Diskussion um den „Tod der BI“ ist symptomatisch für ein Missverständnis, da KI fälschlicherweise als Ersatztechnologie betrachtet wird, obwohl sie tatsächlich eine Verstärkungstechnologie ist. KI beendet die Ära statischer Dashboards, isolierter Dateninseln und die Vorstellung, dass Self-Service allein ein strategisches Ziel ist. Stattdessen eröffnet sie die Möglichkeit, Entscheidungen systematisch zu optimieren. Sie erschließt neue Nutzergruppen, senkt Zugangshürden und beschleunigt Analysezyklen. Aber sie verlangt gleichzeitig qualitativ hochwertige Daten, fachlich aussagekräftige Metadaten, klare Governance und verantwortungsvolle Führung.Business Intelligence stirbt also nicht, sondern wird anspruchsvoller, strategischer und entscheidungszentrierter. Wenn Ihr System heute erklären kann, warum der 28.11. besser lief als der 20.4., dann ist der nächste Schritt nicht nur ein besseres Dashboard. Der nächste Schritt ist ein System, das Ihnen vorschlägt, wie Sie den nächsten Black Friday noch erfolgreicher gestalten – und den nächsten Ostermontag weniger enttäuschend. Und genau dort beginnt die Entscheidungsoptimierung 2.0 [1].
Literaturangaben
[1] Zachrau, T. / Abshoff, S.: Entscheidungsoptimierung 2.0. In: Vortrag auf der TDWI Hot Topics DATA PLATFORM powered by TDWI, 2.12.2025 (Primärquelle des Artikels), https://hottopics.tdwi.eu/data-platform/details/default-c8b5e6d501f104081075f72b26c9a754, abgerufen am 15.8.2026
[2] Li, J. et al.: Can LLM Already Serve as A Database Interface? A BIg Bench for Large-Scale Database Grounded Text-to-SQLs. In: NIPS ’23: Proceedings of the 37th International Conference on Neural Information Processing Systems, Article No.: 1835, 2023
[3] Dorairaj, D.: SAP Agentic AI in Practice: Concepts, Architecture, and Your First LangGraph Agent (Part 1 of 6). 30.3.2026, https://community.sap.com/t5/artificial-intelligence-blogs-posts/sap-agentic-ai-in-practice-conceptsarchitecture-and-your-first-langgraph/ba-p/14361699, abgerufen am 15.8.2026
[4] LangChain: LangChain Docs. https://docs.langchain.com/ und https://docs.langchain.com/langsmith/playground-model-providers#standard-parameters, abgerufen am 15.8.2026
[5] Sahota, H.: Conversational Agents in LangChain. 16.12.2023, https://www.comet.com/site/blog/conversational-agents-in-langchain/, abgerufen am 15.8.2026
[6] Woojin: Custom Agentic Chatbot with SAP AI Core and Joule Studio — Part 1. 6.10.2025, https://community.sap.com/t5/technology-blog-posts-by-sap/custom-agentic-chatbot-with-sap-ai-core-and-joule-studiopart-1/ba-p/14232347, abgerufen am 15.8.2026
[7] Databricks: What is Retrieval Augmented Generation (RAG)? https://www.databricks.com/blog/what-is-retrieval-augmented-generation, abgerufen am 15.8.202
[8] SAP: SAP HANA Cloud, SAP HANA Database Security Guide. https://help.sap.com/docs/hana-clouddatabase/sap-hana-cloud-sap-hana-database-security-guide/analytic-privileges?utm_source=chatgpt.com&locale=en-US, abgerufen am 15.8.2026
[9] Yao, S. et al.: REACT: SYNERGIZING REASONING AND ACTING IN LANGUAGE MODELS. In: Paper presented at 11th International Conference on Learning Representations, ICLR, Kigali, Rwanda, 2023
[10] Reply Syskoplan: SAP Business Data Cloud. https://www.reply.com/syskoplan-reply/de/sap-business-data-cloud, abgerufen am 15.8.2026